title
24秋机器学习笔记-10-无监督学习
date
2024-12-04 07:16:34 -0800
tags
categories
本文主要涉及无监督学习中的降维/聚类方法,介绍了 PCA、k-means 与 EM 算法。
一键回城 。
之前我们学习的都是有监督学习,我们的目标是最小化一个损失函数 $L(f(x),y)$ ,或者最大似然 $P(y|x)$ 。比如回归问题中的线性回归与 GPR,分类问题中的逻辑回归、SVM 与 NN 等。
而无监督学习可以理解为只给一堆 $X$ ,然后学习 $X$ 的分布 $P(X)$ 。
一般有三种:
降维(dimensionality reduction):学习一个更 compact 的 $f(x)$ 的表示。
聚类(clustering):将一系列具有高相似度的样本聚为一类进行分析。
生成式模型:如 ChatGPT,Diffusion 等
一种经典的降维方法,$x\in \mathbb{R}^d \to z \in \mathbb{R}^{d'}$ 其中 $d' < d$ 。
考虑数据在高维空间中分布通常是不均匀的,即在某些维度上变化比较大,而在另一些上比较小。所以我们可以把每个 $x$ 给投影到主成分 $u_1$ 上,用这个一维的投影来表示这个 $x$ ,这就实现了丧失不太多信息的一种降维。
准则:
找到一个新的坐标系 $u_1,u_2$ ;
要求 $u_1$ (其实就是主成分)包含最多的信息,也即要求所有数据在 $u_1$ 上的方差最大化 ;
迭代地寻找其他的使得剩余方差最大的 $u_2,u_3, \cdots$ 。(可以自定义停止条件,即自行决定保留几维)
实际应用中有些数据可能不太满足这种线性性,用一些其他的非线性降维方法可能可以获得更好效果。
令
$$
X = \begin{bmatrix} x_1^T \ x_2^T \ \vdots \ x_n^T \\end{bmatrix} \in \mathbb{R}^{n\times d}
$$
计算均值
$$
\overline{x} = \frac{1}{n} \sum_{i \in [n]} x_i \in \mathbb{R}^d
$$
数据的协方差矩阵为
$$
\Sigma = \frac{1}{n} \sum_{i \in [n]}\left[ (x_i - \overline{x})\cdot (x_i - \overline x)^T \right] \in \mathbb{R}^{d\times d}
$$
严格意义上而言最前面乘上的 $\displaystyle \frac{1}{n}$ 在统计意义上应为 $\displaystyle \frac{1}{n - 1}$ ,不过不影响结果,所以接下来还是用 $\displaystyle \frac{1}{n}$ 推导。注意这个 $\Sigma$ 是实对称的。
为了求出主成分,我们需要一个单位向量 $u_1 \in \mathbb{R}^d$ 来将每个 $x_i$ 投影为 $x_i^T u_1 \in \mathbb{R}$ ,然后最大化其方差。
首先,投影出来的结果的均值为
$$
\frac{1}{n} \sum_{i \in [n]}u_1^T x_i = \frac{1}{n} u_1^T \sum_{i \in [n]}x_i = u_1^T \overline{x}
$$
所以,方差为
$$
\begin{aligned}
\frac{1}{n} \sum_{i \in [n]}(u_1^T x_i - u_1^T \overline{x})^{2} &= \frac{1}{n} \sum_{i \in [n]} u_1^T (x_i - \overline x)(x_i - \overline x)^T u_1 \\
&= u_1^T \Sigma u_1
\end{aligned}
$$
将这个问题写成带约束(约束来源于单位向量)的优化形式
$$
\max_{u_1} u_1^T \Sigma u_1\\
\text{s. t. }u_1^T u_1 = 1
$$
得到拉格朗日函数
$$
\mathcal{L}(u_1, \lambda) = u_1^T \Sigma u_1 + \lambda(1 - u_1^T u_1)
$$
求导:
$$
\frac{\partial \mathcal{L}}{\partial u_1} = 2\Sigma u_1 - 2\lambda u_1 = 0\\
\implies \Sigma u_1 = \lambda u_1
$$
所以 $\lambda$ 是 $\Sigma$ 的特征值 ,$u_1$ 是 $\Sigma$ 的特征向量 。而我们注意到这个方差就是
$$
u_1^T \Sigma u_1 = u_1^T \lambda u_1 = \lambda
$$
要最大化这个 $\lambda$ ,说明 $u_1$ 就是 $\Sigma$ 最大的特征值对应的特征向量 。通过这个过程我们可以看出来 $\Sigma$ 的那个系数是无关紧要的,对我们求一个方向不会产生影响。
接下来考虑求出第二个主成分 $u_2$ 。需要满足的条件为 $u_2$ 为单位向量,且与 $u_1$ 正交。写出带约束的优化问题
$$
\max_{u_2} u_2^T \Sigma u_2\\
\text{s. t. } u_2^Tu_2 = 1, u_2^T u_1 = 0
$$
写出拉格朗日函数并求导:
$$
\begin{aligned}
\mathcal{L}(u_2, \lambda_2, \alpha) &= u_2^T \Sigma u_2 + \lambda_2(1 - u_2^T u_2) + \alpha u_2^T u_1 \\
\frac{\partial \mathcal{L}}{\partial u_2} &= 2 \Sigma u_2 - 2 \lambda_2 u_2 + \alpha u_1 = 0
\end{aligned}
$$
这个时候全部乘一个 $u_1^T$ ,所有的交叉项就可以被消掉了:
$$
\begin{aligned}
2 u_1^T \Sigma u_2 - 2 \lambda_2 u_1^T u_2 + \alpha u_1^T u_1 &= 0 \\
\end{aligned}
$$
注意到 $u_1^T \Sigma u_2 = u_2^T \Sigma u_1 = u_2^T \lambda u_1 = 0$ ,所以 $\alpha = 0$ ,于是 $\Sigma u_2 = \lambda_2 u_2$ 。于是 $u_2, \lambda$ 分别为 $\Sigma$ 的特征向量和特征值。同理,所以 $u_2$ 就是 $\Sigma$ 第二大的特征值对应的特征向量。
可以归纳得到一个很强的结论:
Eckart- Young Theorem
前 $k$ 个主成分就是 $\Sigma$ 的前 $k$ 大的特征值对应的特征向量。
于是我们得到 PCA 算法的通用流程:
计算 $\Sigma$ ;
做特征值分解 $\Sigma = U \Lambda U^T$ ,要求特征值从大到小排列;
选前 $k$ 个特征向量 $[u_1, u_2, \cdots , u_k] = U_{1:k} \in \mathbb{R}^{d \times k}$
$U_{1:k}^T x_i$ 将 $x_i \in \mathbb{R}^d$ 投影到 $\mathbb{R}^k$
实际上,矩阵的特征值(从大到小)会迅速衰减,后面的会变得非常小,所以去掉这些特征维度影响不大。此乃 PCA 分解成功的理论解释。
考虑另一种 PCA 算法。
定义
$$
\hat{X} = \begin{bmatrix} x_1^T - \overline x^T \ \vdots \ x_n^T - \overline x^T \\end{bmatrix} \in \mathbb{R}^{n \times d}
$$
于是 $\Sigma = \displaystyle \frac{1}{n} \hat{X}^T \hat{X}$
由于我们事实上不关心 $\Sigma$ 的特征值,所以可以对 $\hat{X}^T$ 做 SVD:
$$
\hat{X}^T = U S V^T
$$
其中 $U \in \mathbb{R}^{d \times d}, S \in \mathbb{R}^{d \times n}, V \in \mathbb{R}^{n \times n}$ ,且 $U$ 和 $V$ 都是正交阵。
$$
\hat{X}^T \hat{X} = USV^T V S^T U^T = USS^TU^T = U \Lambda U^T
$$
所以对 $\hat{X}^T$ 做 SVD 和对 $\Sigma$ 做特征值分解是一样的。$\hat{X}^T$ 的左奇异矩阵就是特征值分解得到的 $U$ 矩阵。
考虑两种方法的复杂度:对 $\Sigma$ 做特征值分解需要 $O(d^3)$ ,对 $\hat{X}^T$ 做 SVD 只需要 $O(nd^2)$ 。注意到求出 $\Sigma$ 本身就需要 $O(nd^2)$ 了。所以实际上更倾向于使用 SVD。且 SVD 有更好的库/更好的优化方式……
给定 $D = {x_1, \cdots ,x_n}, x_i \in \mathbb{R}^d$ ,我们希望将 $D$ 划分为 $k$ 个类簇(cluster),其中 $k$ 为超参数。
我们需要找到每个类簇的中心点 $\mu_i, i \in [k]$ ,并确定每个数据点的归类。
目标:找到所有的 ${\mu_i \mid i \in [k]}$ 使得每个数据点 $x_i$ 到其所属类簇的中心点的距离平方和最小。这是一个非常符合直觉且朴素的目标。
定义
$$
r_{ij} = \begin{cases} 1, & x_i \text{ is assigned to cluster }j \ 0, & \text{otherwise} \end{cases}
$$
注意其需满足性质 $\forall i, \displaystyle \sum_{j \in [k]} r_{ij} = 1$ 。这与后面提到的高斯混合模型不太一样。
那么 k-means 的目标就可以写成
$$
L := \min_{r,\mu} \sum_{i \in [n]} \sum_{j \in [k]} r_{ij} \left| x_i - \mu_j \right|^{2}
$$
但是 $r_{ij}$ 是离散的,不能求导,这就比较麻烦了。
不过还是可以做的,迭代地重复如下两个步骤:
固定 $\mu$ ,求 $r$ 。
$$
r_{ij} = \begin{cases} 1, & k = \arg\min_{j \in [k]} \left| x_i - x_j \right|^{2} \ 0, & \text{otherwise} \end{cases}
$$
即根据当前 已经确定好的类簇中心来重新分配每个点。
固定 $r$ ,求 $\mu$ 。
$$\begin{aligned}
\frac{\partial L}{\partial \mu_j} &= -\sum_{i \in [n]}r_{ij} \cdot 2 (x_i - \mu_j) = 0 \
\mu_j &= \frac{\sum_{i \in [n]}r_{ij} \cdot x_i}{\sum_{i \in [n]}r_{ij}}
\end{aligned}$$
此时 $\mu_j$ 的意义为在当前 的 $r$ 下,被分配到类簇 $j$ 的所有点的均值。
反复迭代直到收敛($r$ 或 $\mu$ 不再变化),不过为啥 k-means 一定会收敛呢?因为这两个步骤都是会使得损失函数降低的。
不过 k-means 找到的解未必是全局最优解。因为这个迭代流程可以理解为在 $\mu$ 和 $r$ 轴上的梯度下降,自然是不易找到全局最小值的。实际中,使用多个随机初始值来跑,选择损失函数最小的一个作为解。
混合高斯模型(Mixture of Gaussians, MoG) 在 k-means 中,我们用的是 hard assignment。而在 MoG 中,我们将类簇 $j$ 中的数据用高斯分布 $\mathcal{N}(\mu_j, \Sigma_j)$ 来建模。每个类簇有先验权重 $\pi_j$ ,$\sum \pi_j = 1$。
对于一个随机变量 $x$ ,定义 $z_j$ 为隐变量 ,取值为 ${0,1}$ ,$z_j = 1$ 代表 $x$ 在类簇 $j$ 中,反之亦然。显然 $\sum z_j = 1$ 。这个隐变量代表着 $x$ 到底是从哪个类簇中产生的。
MoG 同时也可以是生成模型,可以生成与训练数据分布相似的数据。
于是显然 $P(x\mid z_j = 1) = \mathcal{N}(x\mid \mu_j, \Sigma_j)$ ,注意 $\mu_j$ 和 $\Sigma_j$ 都是我们的概率模型里面的参数,我们之后要优化之。$\mu_j$ 实际上就是类簇 $j$ 的中心点。
但是,我们在训练数据中是不知道每个点是属于哪个类簇的,所以像 $P(x\mid z_j=1)$ 的形式没法直接进行优化。我们需要的是 $P(x)$ 。
$$
\begin{aligned}
P(x) &= \sum_{z} P(x,z) & \text{marginalization} \\
&= \sum_z P(x\mid z) P(z) & \text{note that }z\text{ can be easily enumerated}\\
&= \sum_{j \in [k]} \pi_j \cdot \mathcal{N}(x\mid \mu_j, \Sigma_j)
\end{aligned}
$$
注意到 $z$ 就是类簇分配的 one-hot 编码 ,所以实际上只有 $k$ 种 $z$ ,这就是第二行变换到第三行的原理,即考虑遍历每种可能的隐变量。
对这个东西就可以考虑使用 MLE 来优化其对数似然了:
$$
\max_{\pi,\mu,\Sigma} \sum_{i \in [n]} \log\left( \sum_{j \in [k]}\pi_j \cdot \mathcal{N}(x_i\mid \mu_j, \Sigma_j) \right)\\
\text{s. t. }\sum_{j \in [k]}\pi_j = 1, \forall j,\Sigma_j \succeq 0
$$
如果想用梯度下降的话就需要处理这两个额外的限制条件。前者关于 $\pi$ 的倒是还好,可以利用 softmax 做一些变量替换,但后者就比较麻烦了。所以实际中我们使用 EM 算法来做这样的优化。
Expectation Maximization (EM) 先考虑一般情况下的 EM,推导完毕后再带回 MoG。
假设 $\theta$ 包含全部需要估计的参数。在 MLE 中,我们需要在训练集 ${x_1, \cdots ,x_n}$ 上最大化 $P(x;\theta)$ 。但是 $P(x_i,\theta)$ 由包含隐变量的式子 $P(x_i;\theta) = \displaystyle \sum_{z_j} P(x_i,z_j;\theta)$ 给出。现在我们假设直接优化 $P(x;\theta)$ 是困难的,但优化 $P(x,z;\theta)$ 比较容易。
我们引入一个 $P(z\mid x;\theta)$ 的 approximate distribution(又称为 variational distribution)$q(z\mid x)$
引入一个简单易求的分布 $q$ 来替代复杂难求的后验 $P$ 。
$$
\begin{aligned}
\log P(x;\theta) &= \sum_z q(z\mid x) \cdot \log P(x;\theta) \\
&= \sum_z q(z\mid x) \cdot \left[ \log P(x,z;\theta) - \log P(z\mid x; \theta) \right]\\
&= \sum_z q(z\mid x) \cdot \left[ \log P(x,z;\theta) {\color{red}{ - \log q(z\mid x)}} - \log P(z\mid x; \theta) {\color{red}{+ \log q(z\mid x)}} \right]\\
&= \sum_z q(z\mid x) \log \frac{P(x,z; \theta)}{q(z\mid x)} - \sum_z q(z\mid x) \log \frac{P(z\mid x, \theta)}{q(z\mid x)}\\
&= L(q, \theta) + \mathrm{KL}(q\parallel p)
\end{aligned}
$$
解释:第一行是利用 $\displaystyle \sum_z q(z\mid x) = 1$ 来做恒等变换,第二行则是基于贝叶斯公式 $P(x,z) = P(x)P(z\mid x)$ ,做这些变换的目的是为了凑出 KL 散度 和 ELBO。
先分析右边的 KL 散度(Kullback-Leibler Divergence):其度量两个分布之间的差异。
$$
\mathrm{KL}(p\parallel q) = - \sum_z q(z\mid x) \log P(z\mid x; \theta) - \left[ - \sum_z q(z\mid x) \log q(z\mid x) \right]
$$
后者就是 $q(z\mid x)$ 的熵,而前者为 $p$ 和 $q$ 的交叉熵。
根据 $\log$ 的凸性,有
$$
\sum_z q(z\mid x) \log \frac{P(z\mid x;\theta)}{q(z\mid x)} \le \log \sum_z q(z\mid x) \frac{P(z\mid x; \theta)}{q(z\mid x)} = 0
$$
所以得到 KL 散度非常重要的两个性质:
$\mathrm{KL}(q\parallel p) \ge 0$ ;
等于 $0$ 当且仅当 $p = q$ 。
交叉熵与 KL 散度之间的联系:
对于监督学习 (如逻辑回归),优化交叉熵和 KL 散度是没有区别的。因为 $q$ 是代表真实数据的分布,$p$ 是代表建模出来的分布。KL 散度式子里右边那一项是和我们要优化的参数无关的,为定值,所以等价。交叉熵的计算更简单,一般使用交叉熵。
同时,他们两个都是不对称的。$\mathrm{KL}(p\parallel q) \neq \mathrm{KL}(q\parallel p)$,且 $H(p,q) \neq H(q,p)$ 。
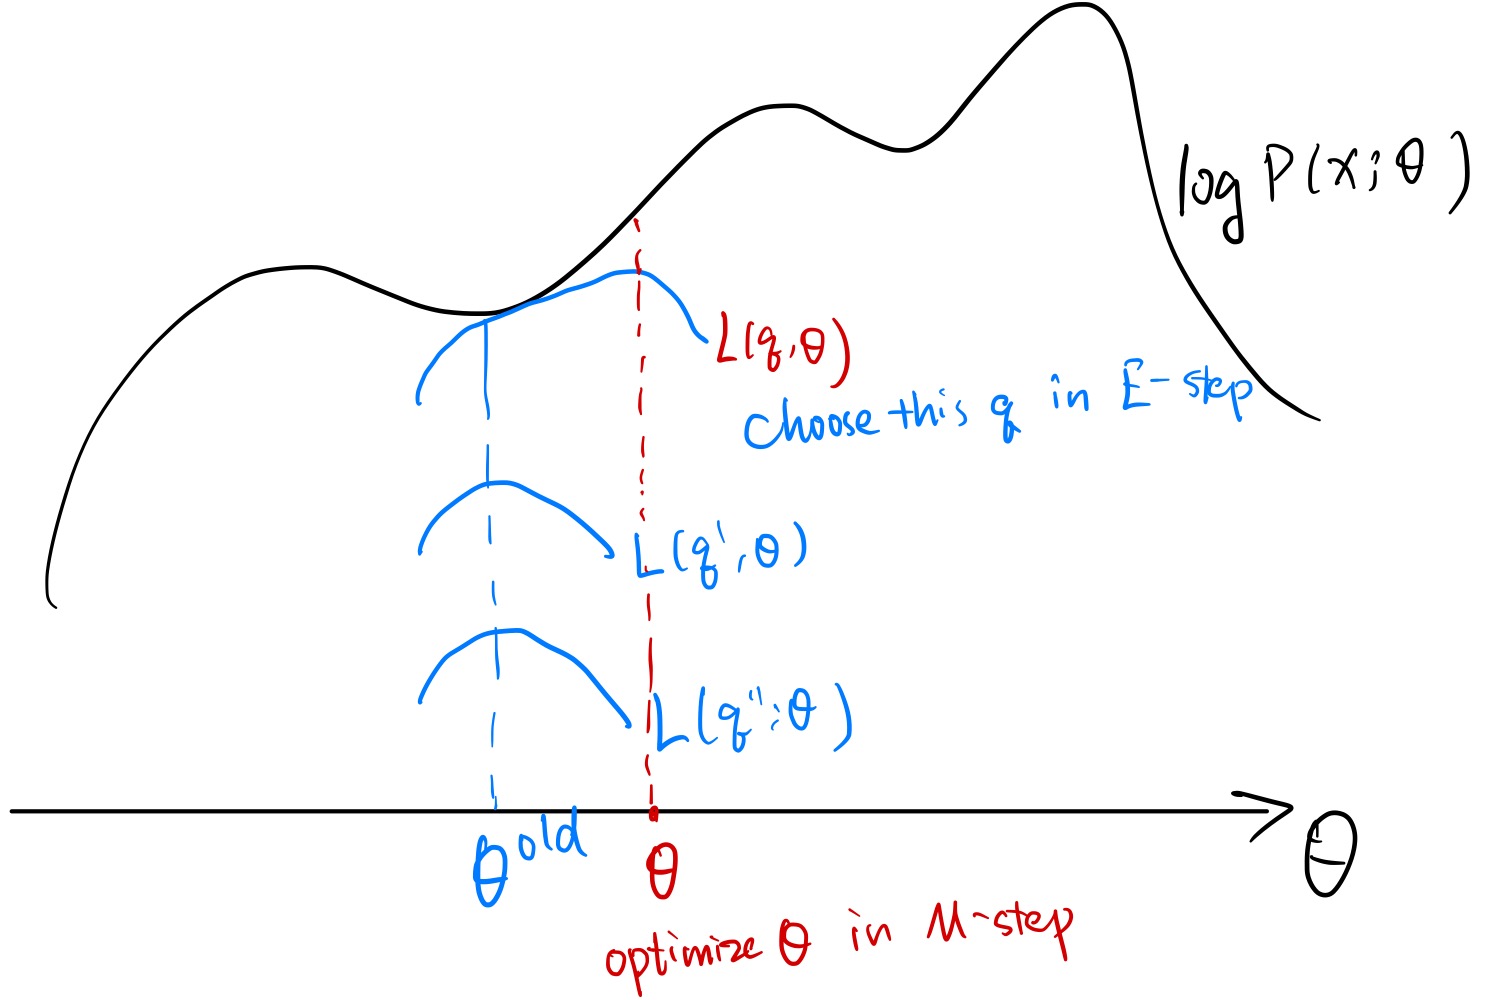
接下来看前面的 $L(q;\theta)$ ,注意到其是一个关于 $q$ 的泛函 (函数的函数,functional)。因为 $\mathrm{KL}(q\parallel p)\ge 0$ ,$L(q;\theta) = \log P(x;\theta) - \mathrm{KL}(q\parallel p) \le \log P(x; \theta)$。所以 $L(q;\theta)$ 是似然 $P(x;\theta)$ 的一个下界 ,称为置信下界 Evidence Lower Bound (ELBO) 。
完成上述推导后正式引入 EM 算法:一种用于优化 ELBO 的两步的迭代算法。注意到这个泛函有 $q,\theta$ 两个“参数”,算法中的两步就是分别在进行优化。
E-step (expectation) :给定 $\theta$ ,优化 $q$ 。现在固定 $\theta = \theta^{\text{old}}$ ,$L(q,\theta^{\text{old}})$ 成为 $q$ 本身的泛函。我们又发现固定 $\theta$ 后,$\log P(x;\theta)$ 也是常数。回忆 ELBO 的式子 $L(q;\theta) = \log P(x;\theta) - KL(q\parallel p)$ ,最大化 ELBO 等价于最小化 $KL(q\parallel p)$ ,所以就让 $q \gets p$ ,即 $q(z\mid x) = P(z\mid x; \theta^{\text{old}})$ 。
M-step (maximization) :给定 $q$ ,优化 $\theta$ 。将上一步的 $q(z\mid x) = P(z\mid x; \theta^{\text{old}})$ 带入 $L(q;\theta)$ 。
$$
\begin{aligned}
L(q;\theta) &= \sum_z P(z\mid x; \theta^{\text{old}}) \log \frac{P(x,z;\theta)}{P(z\mid x; \theta^{old})} \
&= \sum_z P(z\mid x; \theta^{\text{old}}) \log P(x,z;\theta) - \sum_z P(z\mid x; \theta^{\text{old}}) \log(z\mid x; \theta^{\text{old}})\
\end{aligned}
$$
后者是常数,与 $\theta$ 无关,所以等价于优化
$$
\max_\theta \sum_z P(z\mid x; \theta^{\text{old}}) \log P(x,z;\theta)
$$
即等价于优化期望
$$
\mathbb{E}_{z \sim P(z\mid x, \theta^{\text{old}})}\left[ \log P(x,z;\theta) \right]
$$
重复 E-step 和 M-step 直到收敛,示意图如下:
MoG 我们要优化的对数似然为
$$
\log P(X;\theta) = \sum_{i \in [n]} \log \sum_{j \in [K]} \pi_j \mathcal{N}(x_i\mid \mu_j, \Sigma_j)
$$
E-step :拿真实数据在当前参数下的后验来替代变分分布 $q$ 。
$$
\begin{aligned}
q(Z\mid X) &= P(Z\mid X; \mu^{\text{old}}, \Sigma^{\text{old}}, \pi^{\text{old}}) \\
&= \prod_{i \in [n]} P(z_i\mid x_i; \mu^{\text{old}}, \Sigma^{\text{old}}, \pi^{\text{old}})
\end{aligned}
$$
第一行到第二行是基于数据点间分布是独立的。接下来推导
$$
\begin{aligned}
P(z_i\mid x_i; \mu^{\text{old}}, \Sigma^{\text{old}}, \pi^{\text{old}}) &= \frac{P(x_i,z_i)}{P(x_i)} \\
&= \frac{P(x_i\mid z_i) P(z_i)}{P(x_i)}\\
&= \frac{\prod_{j \in [K]}\left[ \pi_j \mathcal{N}(x_i\mid \mu_j, \Sigma_j) \right]^{z_{ij}} }{\sum_{j \in [K]} \pi_j \mathcal{N}(x_i\mid \mu_j, \Sigma_j)}
\end{aligned}
$$
第三行分子上是一个 index trick。
M-step :优化 $\displaystyle \mathbb{E}_{z \sim q(Z\mid X)}[\log P(X,Z\mid \mu, \Sigma, \pi)]$ 。
$$
\begin{aligned}
P(X,Z) &= \prod_{i \in [n]} P(x_i\mid z_i) P(z_i) \\
&= \prod_{i \in [n]}\prod_{j \in [K]}\left[ \pi_j \mathcal{N}(x_i\mid \mu_j, \Sigma_j) \right]^{z_{ij}}
\end{aligned}
$$
要优化的是其期望:
$$
\begin{aligned}
&\mathbb{E}_{z \sim q(Z\mid X)}[\log P(X,Z\mid \mu, \Sigma, \pi)] \\
=& \mathbb{E}_z \left[ \sum_{i \in [n]} \sum_{j \in [K]} z_{ij} {\color{red}{\log \pi_j \mathcal{N}(x_i\mid \mu_j,\Sigma_j)}} \right]\\
=& \sum_{i \in [n]} \sum_{j \in [K]} \mathbb{E}_z[z_{ij}]\log \pi_j \mathcal{N}(x_i\mid \mu_j,\Sigma_j)
\end{aligned}
$$
(上式中红色部分与 $z$ 无关所以可以提出来)。后面的东西是比较好优化的,现在问题关键在于求出 $\mathbb{E}z[z {ij}]$ 是什么。
$$
\begin{aligned}
\mathbb{E}_z[z_{ij}] &= P(z_{ij}=1\mid x_i; \theta^{\text{old}}) \cdot 1 + P(z_{ij}=0\mid x_i;\theta^{\text{old}})\cdot 0 \\
&= P(z_{ij}=1\mid x_i; \theta^{\text{old}})\\
&= \frac{\pi_j \mathcal{N}(x_i\mid \mu_j,\Sigma_j)}{\sum_{t \in [K]} \pi_t \mathcal{N}(x_i\mid \mu_t, \Sigma_t)} := \gamma_{ij}
\end{aligned}
$$
最后一行是因为,在这个式子里所有的参数都是旧参数,所以可以算出来一个常数 $\gamma_{ij}$ 。其物理意义为:responsibility of cluster $j$ to $x_i$ ,或者理解为 soft cluster assignment,类比之前在 k-means 中的 $r_{ij}$ hard assignment。有
$$
\sum_{j \in [K]} \gamma_{ij} = 1
$$
现在可以重写我们需要优化的东西了:
$$
\max_{\mu,\Sigma, \pi} \sum_{i \in [n]}\sum_{j \in [K]} \gamma_{ij} \log \pi_j \mathcal{N}(x_i\mid \mu_k, \Sigma_k)\\
\text{s. t. }\sum_{j \in [K]}\pi_j = 1
$$
将这个限制写在拉格朗日函数中:
$$
\mathcal{L}(\mu,\Sigma,\pi,\lambda) = \sum_{i \in [n]}\sum_{j \in [K]} \gamma_{ij} \log \pi_j \mathcal{N}(x_i\mid \mu_k, \Sigma_k) + \lambda\left( 1 - \sum_{j \in [K]}\pi_j \right)
$$
对于 $\pi$ :考虑令
$$
\begin{aligned}
\displaystyle \frac{\partial \mathcal{L}}{\partial \pi_j} = 0 &\implies \sum_{i \in [n]} \gamma_{ij} \frac{\mathcal{N}(x_i\mid \mu_k, \Sigma_k)}{\pi_j\mathcal{N}(x_i\mid \mu_k, \Sigma_k)} - \lambda = 0\\
&\implies \pi_j \lambda = \sum_{i \in [n]} \gamma_{ij}\\
&\implies \lambda \sum_{j \in [K]}\pi_j = \sum_{i \in [n]}\sum_{j \in [K]}\gamma_{ij}\\
&\implies \lambda = n\\
&\implies \pi_j = \frac{1}{n}\sum_{i \in [n]}\gamma_{ij}
\end{aligned}
$$
第三行是左右对 $j$ 求和以消去 $\lambda$ 。这样我们就求出了 $\pi_j$ 的闭式解,发现还是很符合物理意义的:将每个点被分配到类簇 $j$ 的“responsibility”求均值。
对于 $\mu$ ,先考虑 $\mathcal{N}(x_i\mid \mu_j,\Sigma_j$ 的式子:
$$
\mathcal{N}(x_i\mid \mu_j, \Sigma_j) = \frac{1}{(2\pi)^{\frac{d}{2}} (\det\Sigma_j)^{\frac{1}{2}}} \exp\left( -\frac{1}{2}(x_i - \mu_j)^T \Sigma_j^{-1}(x_i - \mu_j) \right)
$$
然后化简一下原式
$$
\sum_{i \in [n]} \sum_{j \in [K]} \gamma_{ij}\left[ \log \pi_j - \frac{d}{2}\log(2\pi) - \frac{1}{2} \log \det \Sigma_j - \frac{1}{2}(x_i - \mu_j)^T \Sigma_j^{-1}(x_i - \mu_j) \right]
$$
接下来令
$$
\begin{aligned}
\frac{\partial \mathcal{L}}{\partial \mu_j} = 0 &\implies \sum_{i \in [n]} \gamma_{ij} \Sigma_j^{-1}(x_i - \mu_j) = 0 \\
&\implies \sum_{i \in [n]}\gamma_{ij} x_i = \sum_{i \in [n]}\gamma_{ij}\mu_j\\
&\implies \mu_j = \frac{\sum_{i \in [n]}\gamma_{ij}x_i}{\sum_{i \in [n]}\gamma_{ij}}
\end{aligned}
$$
这个结果也挺符合物理直觉的。相当于对所有的 $x_i$ 做关于类簇 $j$ 的 soft assignment 的加权平均。
最后考虑 $\Sigma$ 。由于在化简后的原式中 $\Sigma$ 以 $\Sigma^{-1}$ 的形式出现,所以我们对其逆求偏导:
$$
\begin{aligned}
\frac{\partial \mathcal{L}}{\partial \Sigma_j^{-1}} = 0 &\implies \sum_{i \in [n]}\gamma_{ij} \frac{1}{\det \Sigma_j} \frac{\partial \det\Sigma_j}{\partial \Sigma_j^{-1}} + \gamma_{ij}(x_i - \mu_j)(x_i - \mu_j)^T = 0 \\
&\implies \Sigma_j = \frac{\sum_{i \in [n]}\gamma_{ij}(x_i - \mu_j)(x_i - \mu_j)^T}{\sum_{i \in [n]}\gamma_{ij}}
\end{aligned}
$$
用到的公式:
$$
\frac{\partial a^Txb}{\partial x} = ab^T\
\frac{\partial \det x^{-1}}{\partial x}=- \det x^{-1} \cdot (x^{-1})^T
$$
也有符合直觉的意义:empirical estimation of covariance weighted by $\gamma_{ij}$ 。
MoG 与 k-means 之间的联系:当 $\Sigma_j = \sigma^2 I$ 且 $\sigma \to 0$ 时,MoG 退化为 k-means。大模型已经能对此给出非常详细的解释,不再赘述。