摘要:本文通过向量加算子的实现实践了tl.arange、tl.load、tl.store、tl.program_id和 tl.constexpr 的 Triton kernel 原语。
入门先学 a + b,向量加法可以表示为 向量c = 向量a + 向量b,即把 a 和 b 中对应位置的每个数字相加。
我们先用Pytorch来实现下,我们可以用 torch.randn 来生成随机的向量a、b,在torch里直接相加就可以。
import torch

if __name__ == "__main__":
    N = 16
    a = torch.randn(N, device='cuda')
    b = torch.randn(N, device='cuda')
    c = a + b
    print(a, b, c, sep="\n")
可以得到如下输出结果,第三个tensor的值是前两个tensor对应位置相加。由于是随机数据,所以以下输出结果会变化。
tensor([-0.3947,  0.1963,  0.4782, -0.0215,  1.5055,  0.1066, -0.8224,  0.0999,
        -0.1316,  0.3244, -1.6962, -0.1411,  0.5005,  0.0396,  0.4774,  0.9639],
       device='cuda:0')
tensor([-0.1621, -1.0437,  0.5023,  0.3897,  0.6714, -0.8212, -0.2596, -0.3467,
        -2.2264,  0.7489,  1.3961, -2.1076,  0.0119, -0.8835, -0.4079,  1.8599],
       device='cuda:0')
tensor([-0.5568, -0.8474,  0.9805,  0.3682,  2.1769, -0.7145, -1.0820, -0.2469,
        -2.3581,  1.0732, -0.3000, -2.2486,  0.5124, -0.8439,  0.0695,  2.8238],
       device='cuda:0')
Pytorch是通过调用了aten的aten/src/ATen/native/cuda/CUDALoops.cuh:L334 的 vectorized_elementwise_kernel CUDA kernel来完成计算的。
我们来写我们的Triton kernel。
我们先考虑在1个program内做完,也就是1个Block要完成16个元素的计算。Triton的源码需要使用@triton.jit装饰器,用来标记这是一段Triton kernel函数,使其能够被JIT(即时编译)编译并在GPU上运行。然后我们将tensor做为参数,实际上传递下去的是tensor的data_ptr()也就是指针。空kernel代码如下所示
@triton.jit
def vector_add_kernel(a_ptr, b_ptr, c_ptr):
    pass

def solve(a: torch.Tensor, b: torch.Tensor, c: torch.Tensor, N: int):
    grid = (1,)
vector_add_kernel[grid](a, b, c)kernel内我们需要取出16个元素,对应位置元素相加后存起来即可。可以使用tl.arange生成连续索引[0, 1, ..., 15],那么a的指针就可以用a_ptr + offsets表达,然后使用tl.load取出元素内容。在分别取出a和b后对两者进行相加,最后使用tl.store对结果进行存储,kernel代码如下所示。
import triton
import triton.language as tl

@triton.jit
def vector_add_kernel(a_ptr, b_ptr, c_ptr):
    # 生成连续索引 [0, 1, ..., 15],用于访问 16 个元素
    offsets = tl.arange(0, 16)
    # 根据索引从 a_ptr 指向的地址加载 16 个元素
    a = tl.load(a_ptr + offsets)
    # 根据索引从 b_ptr 指向的地址加载 16 个元素
    b = tl.load(b_ptr + offsets)
    # 对应位置元素相加
    c = a + b
    # 将结果写回到 c_ptr 指向的地址
tl.store(c_ptr + offsets, c)我们接下来验证下这个kernel,我们可以使用torch.empty_like来产生triton_output,然后调用solve即可。
    triton_output = torch.empty_like(a)
solve(a, b , triton_output, N)对比答案可以使用torch.testing.assert_close,所以整个Python程序如下所示
import torch
import triton
import triton.language as tl

@triton.jit
def vector_add_kernel(a_ptr, b_ptr, c_ptr):
    offsets = tl.arange(0, 16)
    a = tl.load(a_ptr + offsets)
    b = tl.load(b_ptr + offsets)
    c = a + b
    tl.store(c_ptr + offsets, c)

def solve(a: torch.Tensor, b: torch.Tensor, c: torch.Tensor, N: int):
    grid = (1,)
    vector_add_kernel[grid](a, b, c)

if __name__ == "__main__":
    N = 16
    a = torch.randn(N, device='cuda')
    b = torch.randn(N, device='cuda')
    torch_output = a + b
    triton_output = torch.empty_like(a)
    solve(a, b , triton_output, N)
    if torch.allclose(triton_output, torch_output):
        print("✅ Triton and Torch match")
    else:
print("❌ Triton and Torch differ")运行上述程序你会得到✅ Triton and Torch match,代表可以对上答案。
如果输入是15个元素呢,是不是使用offsets = tl.arange(0, 15)就能解决问题呢,运行你会得到ValueError: arange's range must be a power of 2,这是Triton本身的限制,因为我们的Block(program, 线程块)处理的数据量通常是 2 的幂。为了避免访问越界,我们需要使用mask。
mask是tl.load和tl.store的一个参数,计算mask将tl.arange的连续索引与15对比即可。
@triton.jit
def vector_add_kernel(a_ptr, b_ptr, c_ptr):
    offsets = tl.arange(0, 16)
    # 计算 mask:只处理 offsets < 15 的位置
    mask = offsets < 15
    a = tl.load(a_ptr + offsets, mask=mask)
    b = tl.load(b_ptr + offsets, mask=mask)
    c = a + b
tl.store(c_ptr + offsets, c, mask=mask)元素个数不一定都为15,1~16都有可能,所以我们将N做为参数传入,完整代码如下。
import torch
import triton
import triton.language as tl

@triton.jit
def vector_add_kernel(a_ptr, b_ptr, c_ptr, N):
    offsets = tl.arange(0, 16)
    mask = offsets < N
    a = tl.load(a_ptr + offsets, mask=mask)
    b = tl.load(b_ptr + offsets, mask=mask)
    c = a + b
    tl.store(c_ptr + offsets, c, mask=mask)

def solve(a: torch.Tensor, b: torch.Tensor, c: torch.Tensor, N: int):
    grid = (1,)
    vector_add_kernel[grid](a, b, c, N)

if __name__ == "__main__":
    for N in range(1, 16+1):
        a = torch.randn(N, device='cuda')
        b = torch.randn(N, device='cuda')
        torch_output = a + b
        triton_output = torch.empty_like(a)
        solve(a, b , triton_output, N)
        if torch.allclose(triton_output, torch_output):
            print("✅ Triton and Torch match")
        else:
print("❌ Triton and Torch differ")运行以上程序会输出16个✅ Triton and Torch match,我们的算子通过了第一阶段的健壮性检测。
我们可以增加tl.arange中end的值,来让更大N运行,你可以动手试试。
1048576是tl.arange的最大值,比如2097152就会报错ValueError: numel (2097152) exceeds triton maximum tensor numel (1048576),Triton 默认 单个 tensor 最多只能有 2^20 = 1048576 个元素。所以我们需要使用多个Block。
Block(program,线程块)是GPU 软件调度的最小可独立调度的单位,我们当然不止1个block,从性能角度,我们也应该使用多个Block来完成任务。
Grid 是由多个 Block 组成的集合,一个 Grid 可以是 1D、2D 或 3D。向量的Block只在 x 方向排列就够了,kernel内我们可以使用tl.program_id(axis=0) 来获取 block 的编号。
然后我们可以通过Triton的device_print将pid输出出来,以下为示例代码。
import triton
import triton.language as tl

@triton.jit
def test_pid_kernel():
    pid = tl.program_id(axis=0)
    tl.device_print('pid', pid)

def solve():
    grid = (2,)
    test_pid_kernel[grid]()

if __name__ == "__main__":
solve()通过运行以上代码,你会得到很多个pid (0, 0, 0) idx () pid: 0和pid (1, 0, 0) idx () pid: 1,因为每个线程都执行了输出操作,我们Triton代码就是通过运行多个线程来完成加速的。
针对我们的程序我们也是要使用pid来控制偏移即可。我们每个Block依旧只做16个元素,需要的Block数就是ceil(N/16),我们可以调用triton.cdiv(N, 16)来计算。kernel内去获取索引,计算当前Block起始索引,然后生成生成当前 block 内的连续索引即可,其他和之前都一致。全部代码如下所示
import torch
import triton
import triton.language as tl

@triton.jit
def vector_add_kernel(a_ptr, b_ptr, c_ptr, N):
    # 获取当前 program 在 在 x 方向 中的索引
    pid = tl.program_id(axis=0)
    # 计算当前 block 的起始元素索引
    block_start = pid * 16
    # 生成当前 block 内的连续索引 [block_start, block_start+1, ..., block_start+15]
    offsets = block_start + tl.arange(0, 16)
    mask = offsets < N
    a = tl.load(a_ptr + offsets, mask=mask)
    b = tl.load(b_ptr + offsets, mask=mask)
    c = a + b
    tl.store(c_ptr + offsets, c, mask=mask)

def solve(a: torch.Tensor, b: torch.Tensor, c: torch.Tensor, N: int):
    grid = (triton.cdiv(N, 16), )
    vector_add_kernel[grid](a, b, c, N)

if __name__ == "__main__":
    N = 12345
    a = torch.randn(N, device='cuda')
    b = torch.randn(N, device='cuda')
    torch_output = a + b
    triton_output = torch.empty_like(a)
    solve(a, b , triton_output, N)
    if torch.allclose(triton_output, torch_output):
        print("✅ Triton and Torch match")
    else:
        print("❌ Triton and Torch differ")
我们可以修改任意 N 来实验不同情况,而在线评测平台online judge 可以帮你自动验证结果是否正确,也就是LeetGPU。这个在线评测平台可以随机生成更多的数据帮你验证算子是否正确,另外其还提供了H200、B200等先进GPU。在Vector Addition 选择Triton并提交上述除main函数的代码,你会获得Success。
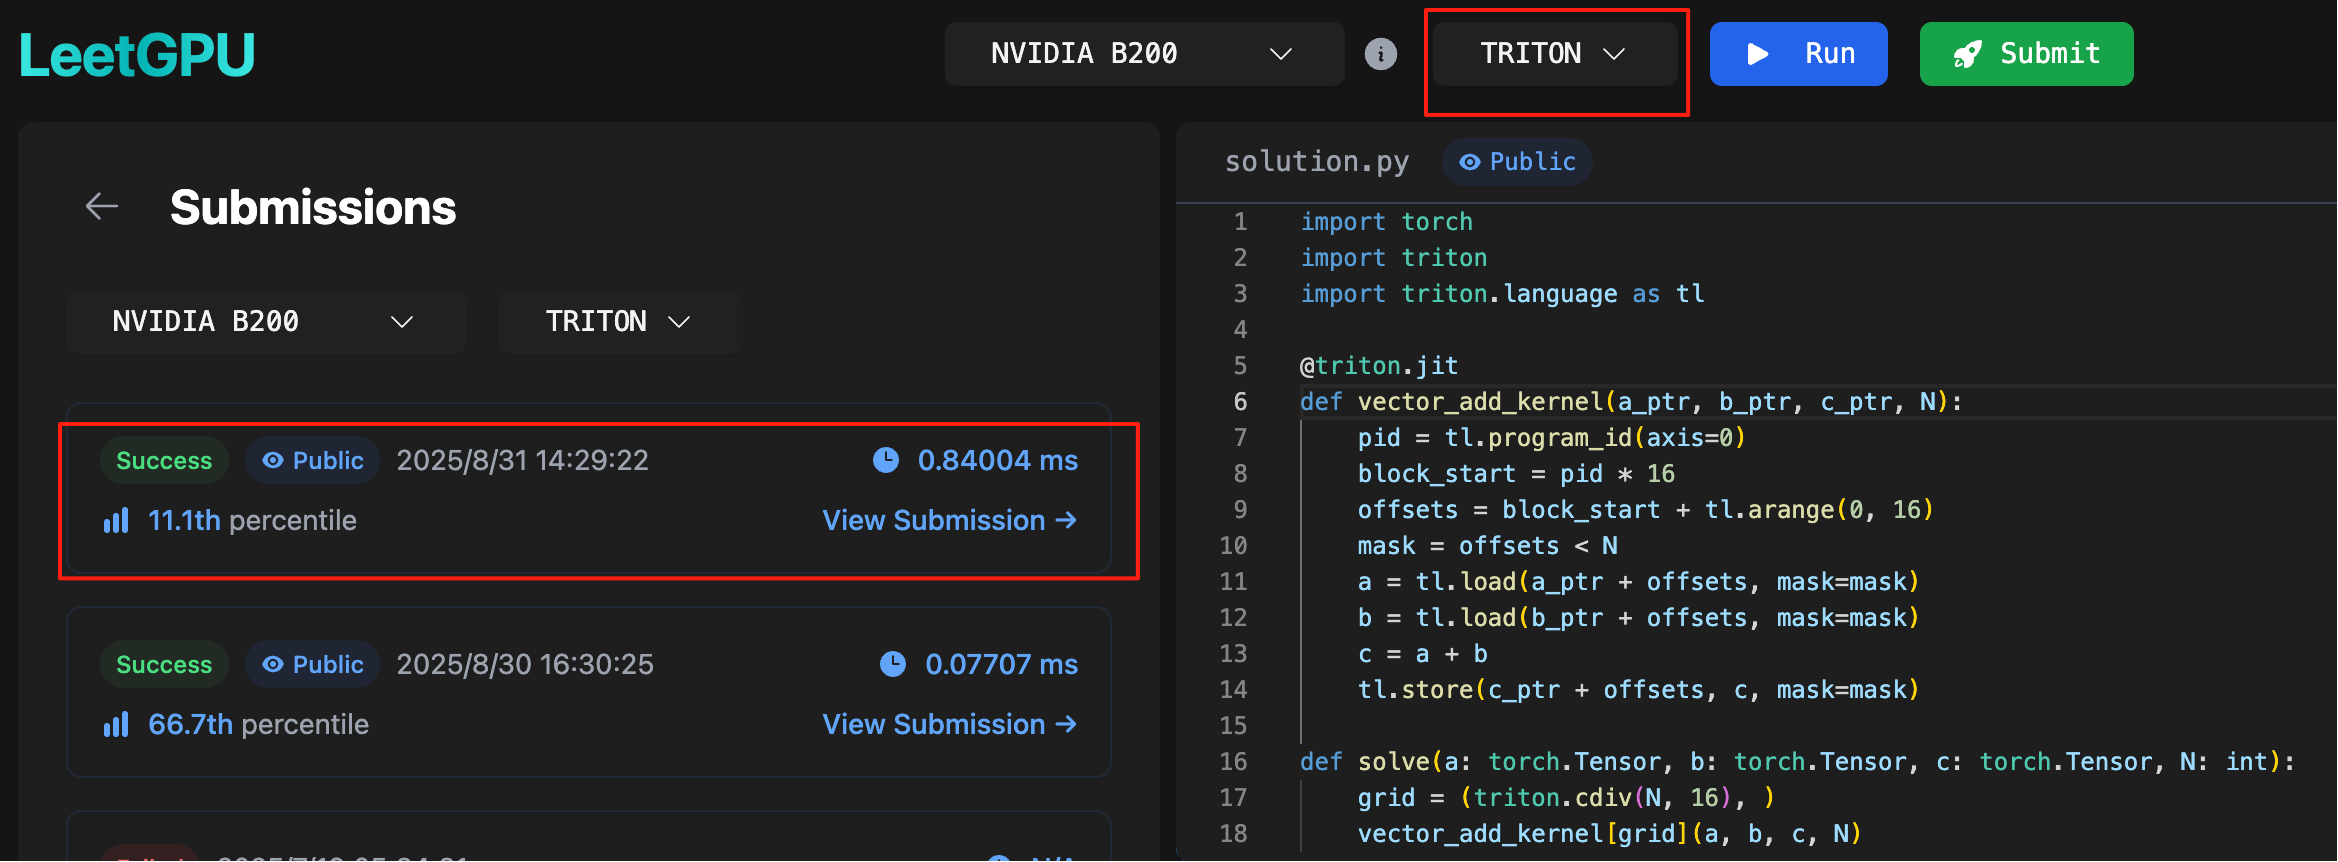
BLOCK_SIZE 我们往往不定义在kernel里,并通过参数传递,方便获得更高性能的算子。BLOCK_SIZE 被限制为常数,需要使用tl.constexpr,然后将16 替换为 BLOCK_SIZE 即可,完整代码如下所示。
import torch
import triton
import triton.language as tl

@triton.jit
def vector_add_kernel(a_ptr, b_ptr, c_ptr, N, BLOCK_SIZE:tl.constexpr):
    pid = tl.program_id(axis=0)
    block_start = pid * BLOCK_SIZE
    offsets = block_start + tl.arange(0, BLOCK_SIZE)
    mask = offsets < N
    a = tl.load(a_ptr + offsets, mask=mask)
    b = tl.load(b_ptr + offsets, mask=mask)
    c = a + b
    tl.store(c_ptr + offsets, c, mask=mask)

def solve(a: torch.Tensor, b: torch.Tensor, c: torch.Tensor, N: int):
    BLOCK_SIZE = 16
    grid = (triton.cdiv(N, BLOCK_SIZE), )
    vector_add_kernel[grid](a, b, c, N, BLOCK_SIZE=BLOCK_SIZE)

if __name__ == "__main__":
    N = 12345
    a = torch.randn(N, device='cuda')
    b = torch.randn(N, device='cuda')
    torch_output = a + b
    triton_output = torch.empty_like(a)
    solve(a, b , triton_output, N)
    if torch.allclose(triton_output, torch_output):
        print("✅ Triton and Torch match")
    else:
print("❌ Triton and Torch differ")我们可以修改BLOCK_SIZE = 16在LeetGPU测试出最好性能的BLOCK_SIZE配置,我测试在B200最合适的BLOCK_SIZE为1024。能不能更快呢,当然可以,你可以和大模型一起学学。
全部代码已保存在ex1-vector_add/vector_add.py 和 ex1-vector_add/vector_add_kernel.py。可以直接命令行运行 ex1-vector_add/vector_add.py。
建议继续使用LeetGPU 练习,可以试试 Matrix Copy Color Inversion Reverse Array Matrix Transpose ReLU Leaky ReLU,都刷完了其他随意。